
Observability ist mehr als Monitoring
Monitoring beantwortet bekannte Fragen: Ist der Dienst erreichbar? Wie hoch ist die CPU-Auslastung? Observability soll zusätzlich helfen, unbekannte Fehlerzustände aus den vorhandenen Signalen zu verstehen. Das ist besonders wichtig in verteilten Systemen, in denen ein Benutzerrequest mehrere Dienste, Queues und Datenbanken durchläuft.
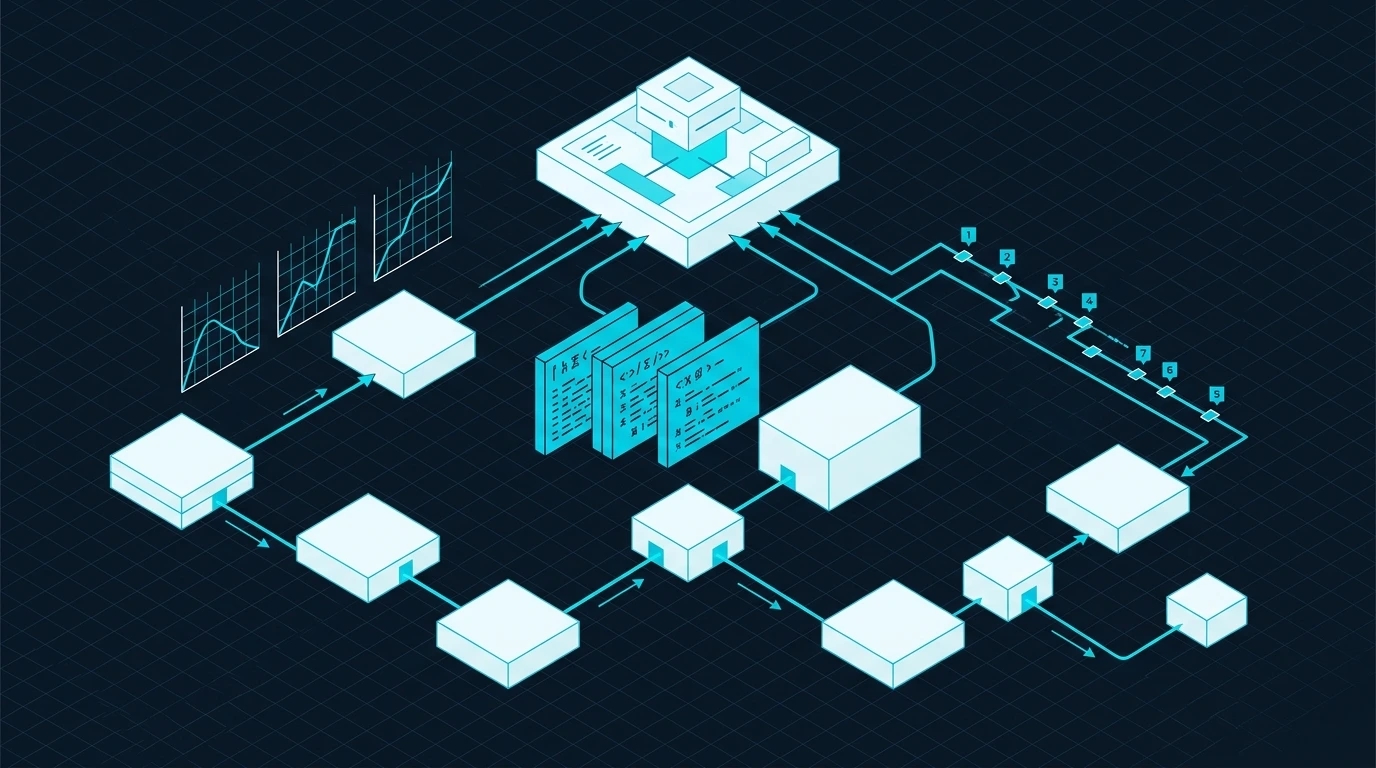
Metriken, Logs und Traces gelten als zentrale Signale. Ihr Wert entsteht jedoch erst durch gemeinsamen Kontext. Zehn Werkzeuge ohne konsistente IDs liefern weniger Erkenntnis als ein kleiner Stack, der denselben Request durch alle Komponenten verfolgen kann.
Mit Nutzer- und Geschäftsproblemen starten
Ein Observability-Projekt sollte nicht mit der Frage beginnen, welche Daten technisch verfügbar sind. Zuerst werden kritische Nutzerabläufe definiert: Anmeldung, Produktsuche, Checkout, Zahlung, Datenimport oder API-Aufruf. Für jeden Ablauf wird festgelegt, was Erfolg bedeutet und welche Fehler sichtbar sein müssen.
Metriken für Trends und Schwellen
Metriken eignen sich für aggregierte Zeitreihen. Antwortzeiten, Fehlerraten, Durchsatz und Sättigung zeigen, ob sich ein System verändert. Gute Labels ermöglichen Segmentierung, ohne unkontrollierte Kardinalität zu erzeugen.
- Technische Metriken mit fachlichen Ergebnissen verbinden.
- Hohe Kardinalität wie Benutzer- oder Request-IDs vermeiden.
- Histogramme für Latenzverteilungen statt nur Mittelwerte verwenden.
- Queue-Alter zusätzlich zur Queue-Länge messen.
- Messwerte pro Version und Umgebung unterscheiden.
Strukturierte Logs mit Kontext
Logs sollten maschinenlesbar sein und konsistente Felder verwenden. Freier Text bleibt für Menschen hilfreich, aber Request-ID, Service, Version, Umgebung und Fehlercode gehören in strukturierte Attribute. Sensible Daten dürfen nicht versehentlich in Logs gelangen.
{
  "level": "error",
  "service": "checkout-api",
  "version": "2026.08.3",
  "requestId": "req_41af8d",
  "orderId": "ord_10241",
  "errorCode": "PAYMENT_TIMEOUT",
  "durationMs": 1820
}
Traces für verteilte Abläufe
Traces verbinden einzelne Spans zu einem Requestpfad. Dadurch wird sichtbar, ob Latenz in der Anwendung, einer Datenbank, einer Queue oder einem externen Dienst entsteht. Sampling muss so gestaltet sein, dass seltene Fehler nicht vollständig verloren gehen.
Nicht jeder interne Funktionsaufruf benötigt einen Span. Sinnvoll sind Systemgrenzen, Datenbankoperationen, externe Requests, Queue-Verarbeitung und fachlich relevante Schritte.
Service Level Objectives und sinnvolle Alerts
Alerts sollten eine notwendige Handlung auslösen. Eine kurzfristig hohe CPU-Auslastung ist nicht automatisch ein Problem, wenn Nutzer keine Beeinträchtigung spüren. Service Level Objectives richten den Blick auf Zuverlässigkeit aus Nutzersicht.
| Signal | Schlechter Alert | Besserer Alert |
|---|---|---|
| Latenz | CPU über 80 Prozent | Checkout-p95 über Ziel bei relevantem Traffic |
| Fehler | Ein einzelner 500er | Fehlerrate über Budget im Zeitfenster |
| Queue | Mehr als 100 Nachrichten | Älteste Nachricht überschreitet Verarbeitungsziel |
Dashboards nach Entscheidungen gestalten
Ein Dashboard sollte eine konkrete Frage beantworten. Ein Betriebsdashboard zeigt Systemzustand und aktuelle Vorfälle. Ein Produktdashboard zeigt fachliche Ergebnisse. Ein Analyse-Dashboard unterstützt Ursachenforschung. Werden alle Informationen auf eine Seite gepackt, verliert das Team den Fokus.
Kosten und Datenmenge kontrollieren
Observability-Daten können schnell wachsen. Aufbewahrung, Sampling und Indexierung benötigen deshalb eine Strategie. Debug-Logs müssen nicht dauerhaft gespeichert werden. Traces können dynamisch nach Fehlern oder hoher Latenz ausgewählt werden. Wichtige Sicherheits- und Auditdaten haben andere Anforderungen als technische Debugdaten.
Schrittweise Einführung
- Einen kritischen Nutzerablauf auswählen.
- Gemeinsame Request- und Trace-IDs einführen.
- Wenige belastbare Metriken und Fehlercodes definieren.
- Alerts mit klarer Reaktion formulieren.
- Während echter Vorfälle prüfen, welche Informationen fehlen.
- Standards auf weitere Dienste übertragen.
Fazit
Observability entsteht nicht durch möglichst viele Daten, sondern durch verbundenen Kontext und klare Fragen. Metriken zeigen Veränderungen, Logs erklären Ereignisse und Traces verbinden verteilte Abläufe. Wenn Alerts an Nutzerwirkung gekoppelt sind, wird Beobachtbarkeit zu einem praktischen Werkzeug für stabilen Betrieb.