
Autoscaling löst keine ineffiziente Anwendung
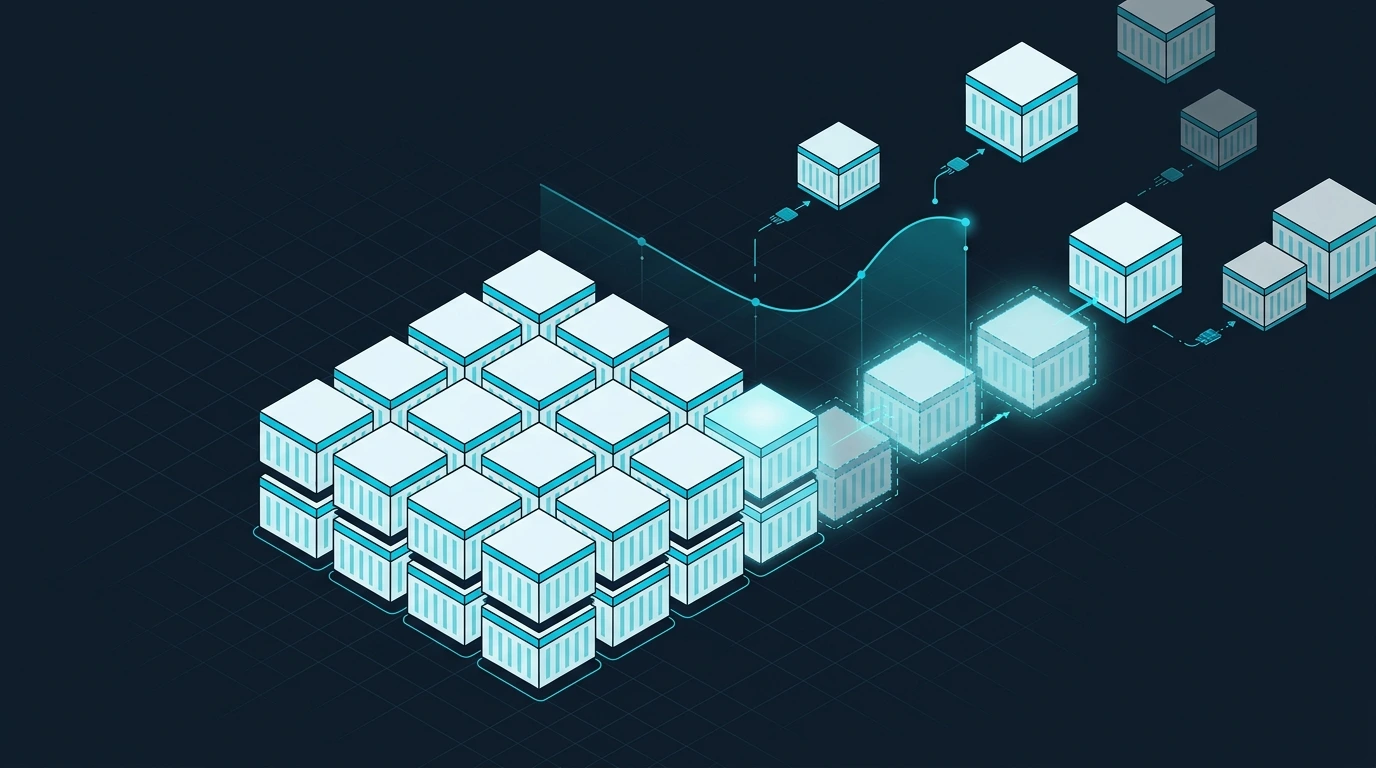
Kubernetes kann Replikate und Clusterkapazität automatisch anpassen. Das bedeutet jedoch nicht, dass jede Lastspitze zuverlässig abgefangen wird. Skalierung funktioniert nur, wenn Ressourcenanforderungen, Metriken und Startverhalten der Anwendung realistisch konfiguriert sind.
Bevor ein Autoscaler eingesetzt wird, sollte klar sein, welche Komponente tatsächlich limitiert: CPU, Speicher, externe APIs, Datenbankverbindungen oder eine Queue. Mehr Pods helfen nicht, wenn alle Instanzen auf dieselbe gesättigte Datenbank zugreifen.
Requests und Limits als Grundlage
Der Scheduler benötigt Resource Requests, um Pods auf Nodes zu platzieren. Der Horizontal Pod Autoscaler nutzt bei CPU-basierten Regeln das Verhältnis zwischen Nutzung und Request. Unrealistische Werte führen deshalb zu falschen Entscheidungen.
- Requests anhand gemessener normaler Last setzen.
- Spitzen und Startphasen getrennt betrachten.
- Speicherlimits vorsichtig konfigurieren, da Überschreitung Prozesse beendet.
- CPU-Limits auf mögliche Drosselung prüfen.
- Werte nach Releases und Lasttests erneut bewerten.
Horizontal Pod Autoscaler verstehen
Der HPA passt die Anzahl der Replikate eines skalierbaren Workloads an beobachtete Metriken an. Typische Grundlagen sind CPU, Speicher oder benutzerdefinierte Metriken. Der Regelkreis arbeitet periodisch und reagiert daher nicht ohne Verzögerung.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: checkout-api
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: checkout-api
  minReplicas: 3
  maxReplicas: 20
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 65
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
Die richtige Metrik wählen
CPU ist einfach verfügbar, aber nicht für jeden Dienst aussagekräftig. Ein I/O-lastiger API-Dienst kann bei niedriger CPU bereits durch Verbindungen oder externe Wartezeiten begrenzt sein. Queue-Worker lassen sich oft besser anhand der ältesten Nachricht oder der erwarteten Abarbeitungszeit skalieren.
| Workload | Mögliche Metrik | Risiko |
|---|---|---|
| HTTP-API | Requests, Latenz oder CPU | Datenbank wird zum Engpass |
| Queue-Worker | Queue-Alter oder Backlog pro Pod | zu schnelles Scale-down |
| Batch-Prozess | offene Arbeitseinheiten | hohe Startkosten |
| Websocket-Service | aktive Verbindungen | ungleichmäßige Verteilung |
Startzeit und Readiness berücksichtigen
Neue Pods helfen erst, wenn sie tatsächlich Traffic verarbeiten können. Große Images, Migrationen beim Start oder langsame Initialisierung verlängern die Reaktionszeit. Readiness-Probes dürfen einen Pod erst freigeben, wenn alle notwendigen Abhängigkeiten verfügbar sind.
Startup-Probes verhindern, dass langsame Anwendungen frühzeitig neu gestartet werden. Liveness-Probes sollten nur echte Deadlocks erkennen und nicht externe Abhängigkeiten prüfen, deren Ausfall ein Neustart nicht behebt.
Scale-up und Scale-down stabilisieren
Ein aggressives Scale-up kann bei plötzlicher Last sinnvoll sein. Scale-down sollte häufig langsamer erfolgen, damit kurzfristige Schwankungen nicht zu ständigem Starten und Stoppen führen. Stabilization Windows und Skalierungsrichtlinien reduzieren dieses Flattern.
Vertikale und Cluster-Skalierung
Der Vertical Pod Autoscaler kann Empfehlungen für Requests liefern oder Ressourcen verändern. Das kann Neustarts erfordern und muss mit dem HPA abgestimmt werden. Der Cluster Autoscaler oder eine vergleichbare Plattformfunktion stellt Nodes bereit, wenn Pods wegen fehlender Kapazität nicht geplant werden können.
Diese Ebenen besitzen unterschiedliche Verzögerungen. Ein Pod kann schnell erstellt werden, ein neuer Node benötigt deutlich länger. Für kritische Dienste ist deshalb eine Mindestkapazität notwendig.
Kosten und Grenzen sichtbar machen
- Minimale und maximale Replikate bewusst festlegen.
- Skalierung gegen reale Lastprofile testen.
- Kosten pro Request oder Auftrag beobachten.
- Abhängigkeiten und Connection Pools mit skalieren.
- Fehlende Metriken und Autoscaler-Entscheidungen alarmieren.
Fazit
Kubernetes-Autoscaling ist ein Regelkreis, kein Ersatz für Kapazitätsplanung. Gute Requests, passende Metriken, schnelle Startzeiten und kontrollierte Grenzen machen Skalierung zuverlässig. Entscheidend ist immer, das gesamte System inklusive Datenbanken und externen Diensten zu betrachten.